 By Marco Hugo Barsotti MHB

Sono passati ben quattro anni dal nostro ultimo articolo dedicato all’analisi della diffusione dei quotidiani in Italia. La recente decisione del principale tra essi, il Corriere della Sera, di ridurre la foliazione ci ha convinto che fosse il momento di tornare a guardare i numeri e magari fare qualche considerazione: anche perché, come sostenevamo allora, la correlazione tra vera libertà di stampa e voglia dei lettori di acquistare un quotidiano o abbonarsi ad una edizione digitale non è mai stata smentita.
Sintesi
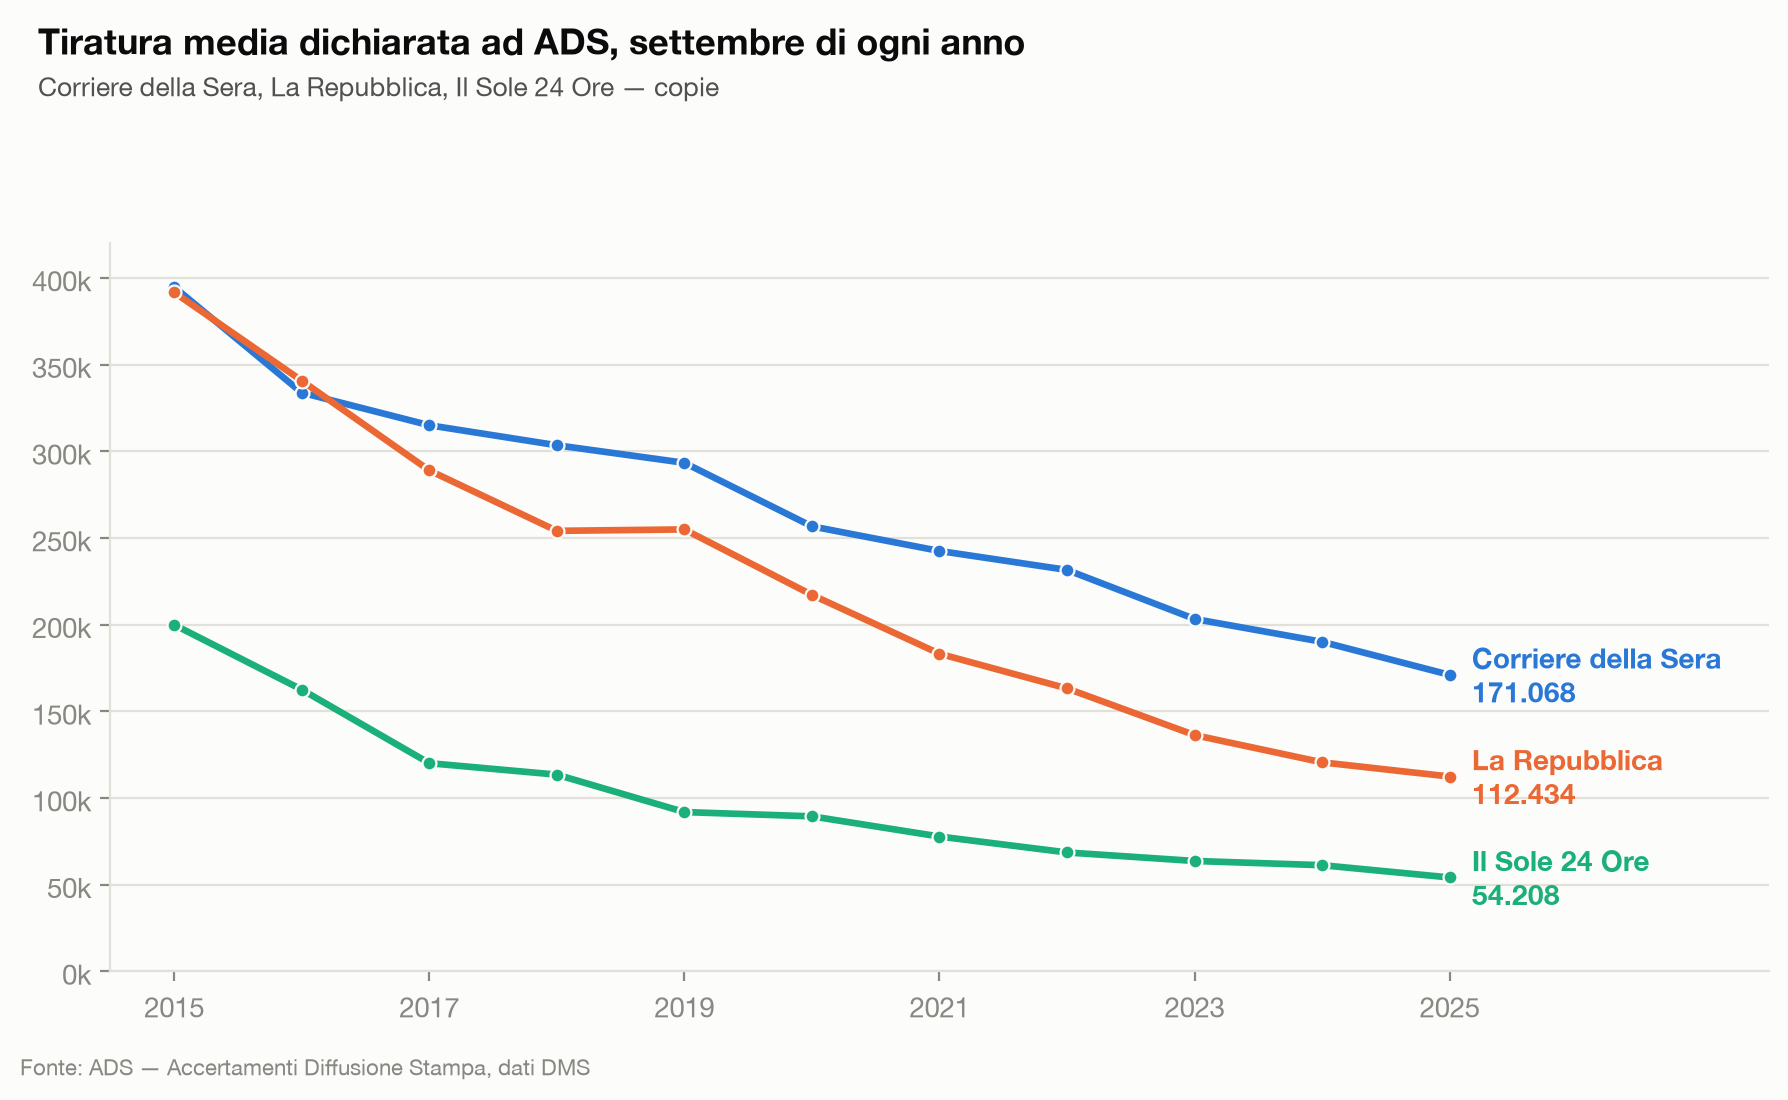
La tiratura di settembre crolla ancora su tutte le testate monitorate: Corriere della Sera -29% in quattro anni (da 242.534 a 171.068 copie), La Repubblica -39% (da 183.267 a 112.434), Il Sole 24 Ore -30% (da 77.831 a 54.208).
La proiezione lineare del 2021 dava Repubblica a zero copie nel 2028: rifatta oggi sui dati 2015-2025, la stessa proiezione dà ancora il 2028.
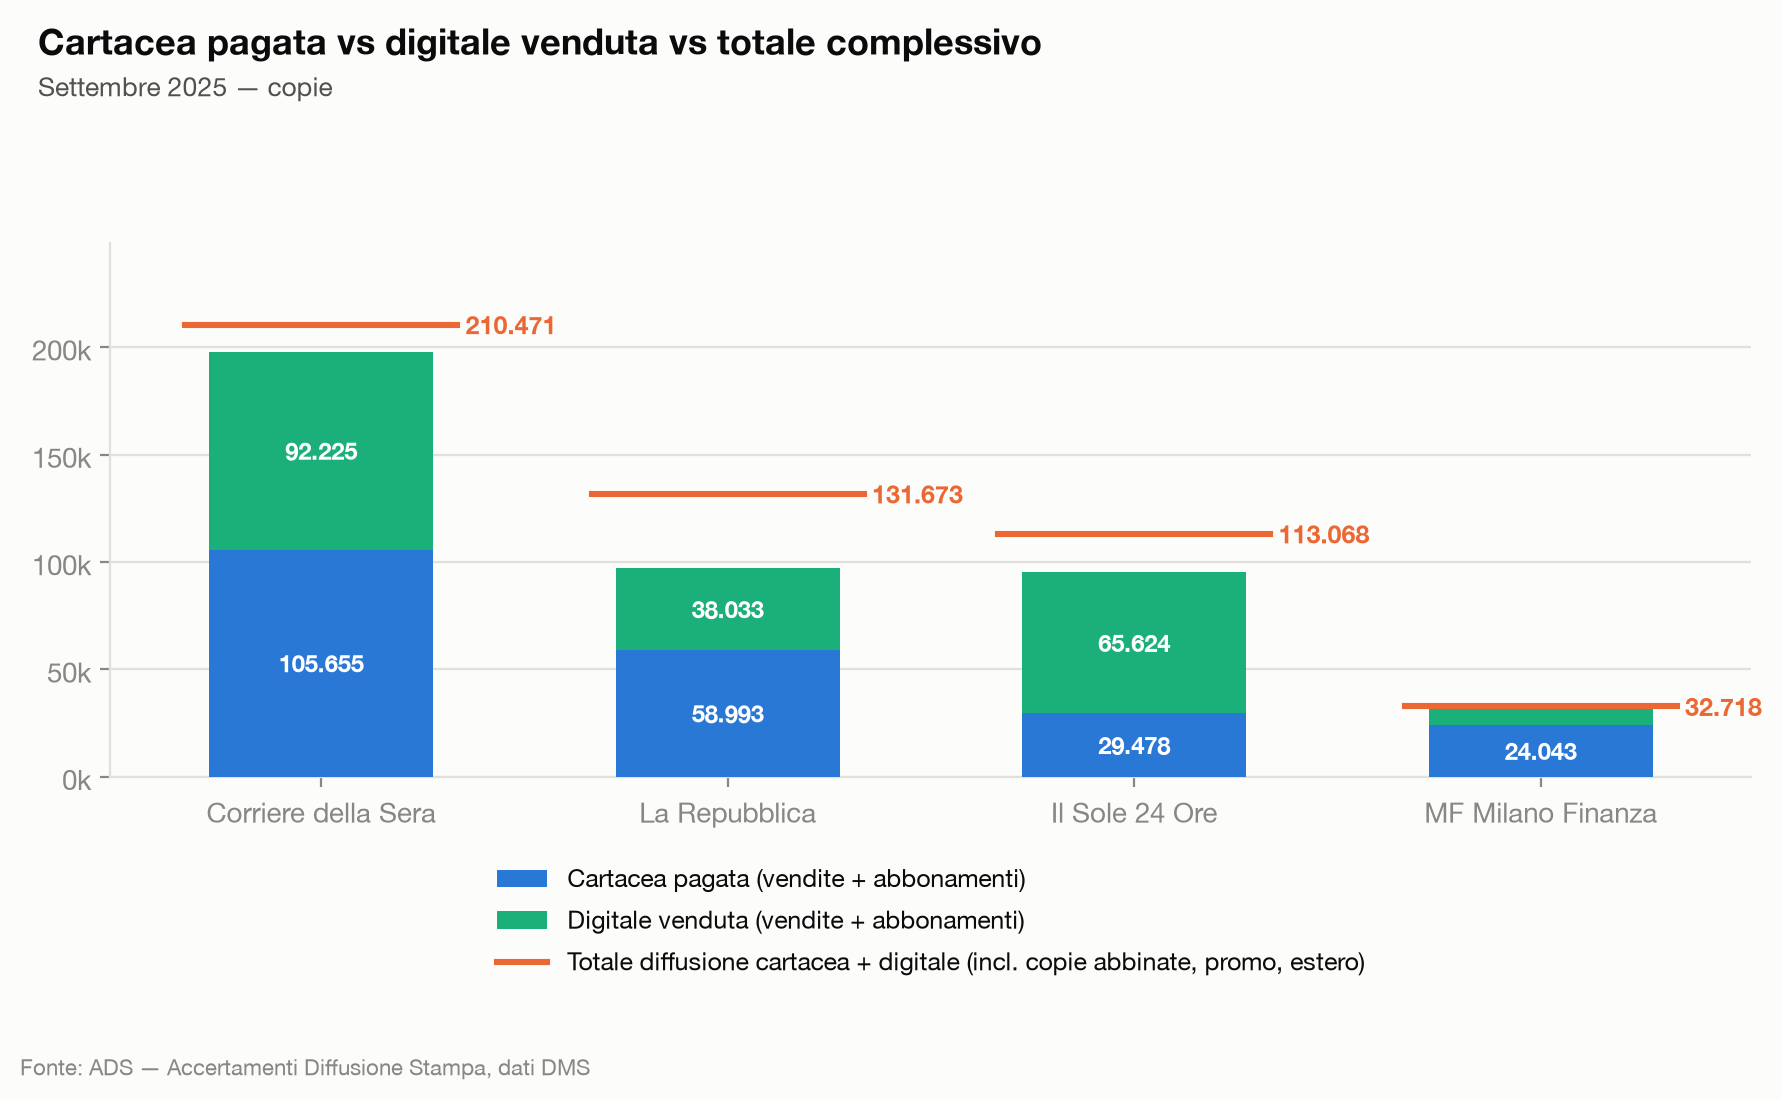
Per la prima volta distinguiamo cartacea pagata e digitale venduto: al Sole 24 Ore il digitale (65.624 copie) supera già il cartaceo (29.478).
Sommando cartacea e digitale, il crollo rallenta ma non si ferma: il totale complessivo del Corriere passa da 255.119 (2021) a 210.471 (2025), -17% anziché -29%.
MF Milano Finanza, classificata da ADS come settimanale e non come quotidiano, è la testata più stabile: -11% in due anni.
ADS non certifica dati di ascolto/abbonamento podcast: quel pezzo di “contenuto fruito” resta fuori da ogni conteggio ufficiale.
La carta si accorcia
Da ottobre 2026 il Corriere della Sera taglia le pagine: l’edizione nazionale passa da 21-22 a 18-19 pagine, alcune edizioni locali (Bergamo, Brescia, Bologna, Firenze, Napoli, Bari, Trento) scendono a 8 pagine. È la parte più visibile di un piano di riorganizzazione digital first annunciato dalla direzione, che sposta redattori dalla carta al digitale.
ADS, quattro anni dopo
ADS (Accertamenti Diffusione Stampa) ha cambiato pelle: il vecchio motore di ricerca CSV del sito adsnotizie.it usato nel 2021 non esiste più, sostituito da file Excel mensili e annuali scaricabili testata per testata. Il che, detto per inciso, è anche un piccolo miglioramento di trasparenza.
Novità più sostanziale: da qualche anno ADS pubblica anche un totale ufficiale cartacea + digitale per ogni testata — la somma che nel 2021 dicemmo di non riuscire a costruire in modo convincente. Oggi esiste, ed è la base del secondo grafico di questo articolo.
Niente più R
Nel 2021 usavamo il linguaggio R, codice incluso in fondo all’articolo perché chiunque potesse riverificare i conti. Questa volta l’estrazione dai file ADS e le regressioni sono state fatte in Python: stesso principio di allora, stessa scelta di pubblicare tutto — dati, codice e link alle fonti sono in appendice, in fondo a questo articolo.
Il metodo aggiornato
Restiamo su Corriere della Sera, La Repubblica, MF Milano Finanza e aggiungiamo Il Sole 24 Ore, escluso nel 2021 per la vicenda della diffusione gonfiata dell’era Napoletano ma oggi pienamente confrontabile. Il dato scelto resta lo stesso: settembre di ogni anno, dal 2015 (primo anno con dettaglio digitale nel nuovo formato ADS) al 2025.
Ma per la prima volta separiamo tre livelli: tiratura (copie stampate, il vecchio indicatore), diffusione pagata distinta in cartacea e digitale (vendite e abbonamenti effettivamente venduti), e totale cartacea + digitale certificato da ADS, che include anche copie digitali abbinate all’abbonamento cartaceo, promozionali ed estero.
Corriere della Sera
La tiratura di settembre passa da 242.534 copie (2021) a 171.068 (2025): -29% in quattro anni, dopo il -74% già maturato tra il 1998 (918.000 copie) e il 2021. Il crollo non rallenta.
La Repubblica
Da 183.267 a 112.434 copie: -39% in quattro anni, il calo percentuale più marcato tra i quotidiani generalisti. La regressione lineare 2015-2025 proietta lo zero copie nel 2028 — esattamente l’anno che la regressione del 2021 (costruita su dati 1998-2021) già indicava. A quattro anni di distanza, Repubblica è rimasta sulla traiettoria prevista, copia per copia.
Il Sole 24 Ore
Da 77.831 a 54.208 copie di tiratura: -30%. Ma è la testata dove la distinzione cartacea/digitale conta di più: nel 2025 la diffusione digitale venduta (65.624 copie) è più del doppio di quella cartacea pagata (29.478). Un quotidiano economico-finanziario, letto da un pubblico abituato a pagare per l’informazione online, è oggi più digitale che di carta.
MF Milano Finanza
ADS la classifica come settimanale e non come quotidiano. I dati disponibili in questo formato coprono solo il 2023-2025, ma mostrano la testata più stabile del lotto: tiratura da 46.241 a 41.230 copie, -11% in due anni, contro il -20/-25% delle altre nello stesso periodo. Conferma quanto scrivevamo nel 2021: un segmento verticale ben definito protegge meglio della generalista.
Il digitale rallenta, non ferma
Sommando cartacea e digitale (il totale ufficiale ADS), il quadro migliora ma non si ribalta. Il Corriere passa da 255.119 (2021) a 210.471 (2025): -17% invece di -29%. Repubblica da 157.228 a 131.673: -16% invece di -39%. Il Sole 24 Ore da 134.533 a 113.068: -16% invece di -30%.
Rifacendo la regressione sul totale anziché sulla sola tiratura, lo zero copie del Corriere si sposta dal 2033 al 2043: un decennio di ossigeno in più, comprato dal digitale. Per Repubblica e Sole 24 Ore il guadagno è più modesto, due-tre anni.
Quello che ADS non misura
Ci era stato chiesto di includere, se possibile, gli abbonati podcast delle testate. Non lo abbiamo fatto: ADS certifica diffusione cartacea e copie digitali (app, e-edition, abbonamenti web), non ascolti audio. I podcast editoriali di Corriere, Repubblica e Sole 24 Ore vivono su piattaforme come Spotify e Apple Podcasts, fuori da qualunque accertamento indipendente pubblico: un buco di trasparenza che, a differenza della carta e del digitale testuale, nessuno certifica.
Quattro anni dopo, la fotografia è più sfumata ma non più confortante. La carta continua a perdere terreno alla stessa velocità di prima; il digitale non compensa, ma allunga la vita del prodotto giornale di qualche anno prezioso. Resta il punto che facevamo nel 2021: dove i lettori continuano a pagare — in edicola o online — c’è ancora un’informazione che si regge sulle proprie gambe. Dove smettono di pagare, prima o poi, smette anche il giornale. (M.H.B. per NL)
Appendice: dati, codice e fonti
Come nel 2021, pubblichiamo dati grezzi e codice per chi vuole rifare i conti da sé.
Tabella dati (settembre 2015-2025)
| Testata | Anno | Tiratura | Cartacea pagata | Digitale venduto | Totale cart.+dig. |
|---|---|---|---|---|---|
| Corriere della Sera | 2015 | 394.784 | 229.042 | 57.719 | 369.391 |
| Corriere della Sera | 2016 | 333.841 | 216.578 | 48.040 | 310.437 |
| Corriere della Sera | 2017 | 315.053 | 200.909 | 49.099 | 284.801 |
| Corriere della Sera | 2018 | 303.517 | 197.522 | 49.817 | 278.334 |
| Corriere della Sera | 2019 | 293.393 | 187.668 | 50.695 | 268.950 |
| Corriere della Sera | 2020 | 256.727 | 166.571 | 69.849 | 256.831 |
| Corriere della Sera | 2021 | 242.534 | 156.680 | 80.159 | 255.119 |
| Corriere della Sera | 2022 | 231.603 | 152.296 | 93.642 | 262.915 |
| Corriere della Sera | 2023 | 203.310 | 132.837 | 100.041 | 247.236 |
| Corriere della Sera | 2024 | 190.145 | 120.561 | 97.676 | 231.661 |
| Corriere della Sera | 2025 | 171.068 | 105.655 | 92.225 | 210.471 |
| La Repubblica | 2015 | 391.682 | 231.656 | 57.122 | 327.329 |
| La Repubblica | 2016 | 340.745 | 222.816 | 29.870 | 269.474 |
| La Repubblica | 2017 | 288.998 | 174.217 | 28.977 | 221.531 |
| La Repubblica | 2018 | 254.156 | 153.284 | 45.019 | 215.029 |
| La Repubblica | 2019 | 254.970 | 147.411 | 46.569 | 203.515 |
| La Repubblica | 2020 | 217.203 | 132.430 | 51.437 | 187.327 |
| La Repubblica | 2021 | 183.267 | 104.677 | 51.193 | 157.228 |
| La Repubblica | 2022 | 163.251 | 89.456 | 46.298 | 137.130 |
| La Repubblica | 2023 | 136.337 | 76.322 | 41.269 | 150.701 |
| La Repubblica | 2024 | 120.616 | 67.058 | 40.515 | 145.082 |
| La Repubblica | 2025 | 112.434 | 58.993 | 38.033 | 131.673 |
| Il Sole 24 Ore | 2015 | 199.945 | 125.303 | 180.109 | 368.754 |
| Il Sole 24 Ore | 2016 | 162.563 | 97.791 | 56.784 | 193.611 |
| Il Sole 24 Ore | 2017 | 120.132 | 75.909 | 59.561 | 168.007 |
| Il Sole 24 Ore | 2018 | 113.522 | 66.450 | 62.803 | 159.495 |
| Il Sole 24 Ore | 2019 | 91.938 | 57.989 | 55.452 | 141.478 |
| Il Sole 24 Ore | 2020 | 89.471 | 53.168 | 63.922 | 143.540 |
| Il Sole 24 Ore | 2021 | 77.831 | 45.002 | 68.736 | 134.533 |
| Il Sole 24 Ore | 2022 | 68.643 | 40.605 | 71.097 | 129.979 |
| Il Sole 24 Ore | 2023 | 63.731 | 36.705 | 69.146 | 123.573 |
| Il Sole 24 Ore | 2024 | 61.297 | 33.336 | 67.287 | 117.886 |
| Il Sole 24 Ore | 2025 | 54.208 | 29.478 | 65.624 | 113.068 |
| MF Milano Finanza | 2023 | 46.241 | 29.672 | 6.220 | 36.878 |
| MF Milano Finanza | 2024 | 41.870 | 24.819 | 6.463 | 32.498 |
| MF Milano Finanza | 2025 | 41.230 | 24.043 | 7.638 | 32.718 |
Dato di settembre di ogni anno. “Cartacea pagata” = vendite individuali + abbonamenti individuali + vendite multiple + abbonamenti multipli, tutti cartacei. “Digitale venduto” = vendite + abbonamenti digitali (individuali e multipli), esclude copie digitali abbinate a un abbonamento cartaceo e copie omaggio. “Totale cartacea + digitale” = colonna ufficiale ADS (include anche copie abbinate, promozionali ed estero). Somma “Cartacea pagata” + “Digitale venduto” = colonna ufficiale ADS “Totale diffusione pagata Italia” — verificato riga per riga, scarto zero salvo arrotondamenti di 1 copia.
Fonti dirette (file ADS scaricabili)
- Dati mensili (settembre 2015-2025):
https://www.adsnotizie.it/Dati/downloadDMS?mese=9&anno={2015..2025}&periodicita={1|6}&nomeReport=DMSFilePubblicato_3(periodicità 1 = quotidiani, per Corriere della Sera / La Repubblica / Il Sole 24 Ore; periodicità 6 = settimanali, per MF Milano Finanza dal 2023) - Dati annuali certificati: 2021, 2022, 2023, 2024
- Pagina di consultazione: adsnotizie.it/Dati/DMS_Page e adsnotizie.it/Dati/DatiMedi_Page
Codice: estrazione colonne dai file ADS
Individua le colonne per testo dell’intestazione (ADS cambia leggermente la struttura tra un anno e l’altro) invece che per indice fisso.
#!/usr/bin/env python3
"""Header-text-driven parser: locates columns by matching header text across the
first 4 rows of each ADS sheet, rather than trusting fixed indices (which shift
across years / report versions). Applies uniformly to monthly DMS files and
annual Certificati/Dichiarati files."""
import openpyxl
import csv
import re
import warnings
warnings.filterwarnings("ignore")

TARGETS = {
    "CORRIERE DELLA SERA": "Corriere della Sera",
    "REPUBBLICA (LA)": "La Repubblica",
    "SOLE 24 ORE (IL)": "Il Sole 24 Ore",
    "MILANO FINANZA": "MF Milano Finanza",
}


def norm(s):
    if s is None:
        return ""
    return re.sub(r"\s+", " ", str(s).replace("\xa0", " ")).strip().upper()


def header_rows(ws, max_rows=5):
    rows = []
    for i, row in enumerate(ws.iter_rows(values_only=True)):
        rows.append(row)
        if i >= max_rows - 1:
            break
    return rows


def find_col(headers, ncols, *needles, exclude=()):
    """Match needles against each column's OWN header text only (no forward-
    fill across merged cells) - every anchor label we rely on is written once,
    directly in its own column, in every ADS report variant seen. Forward-
    filling group labels caused false matches on sibling leaf columns."""
    matches = []
    for c in range(ncols):
        combined = " ".join(norm(hr[c]) for hr in headers if c < len(hr))
        if all(n in combined for n in needles) and not any(e in combined for e in exclude):
            matches.append(c)
    return matches


def with_tier_pair(cols, ncols):
    """The %>=30 / %10-30 (and similar) tiers share one label written only on
    the first column; the second (anchor+1) carries just the tier percentage.
    Expand each anchor match to include its adjacent tier column."""
    out = set()
    for c in cols:
        out.add(c)
        if c + 1 < ncols:
            out.add(c + 1)
    return sorted(out)


def parse_sheet(ws, anno_label, tipo, source):
    rows = list(ws.iter_rows(values_only=True))
    if not rows:
        return []
    ncols = max(len(r) for r in rows[:6])
    headers = rows[:4]

    name_col = 0  # Testata is always first column in every variant seen
    tiratura_cols = find_col(headers, ncols, "TIRATURA")
    dig_ind_cols = with_tier_pair(find_col(headers, ncols, "VENDITE COPIE DIGITALI INDIVIDUAL"), ncols)
    dig_mult_cols = with_tier_pair(find_col(headers, ncols, "VENDITE MULTIPLE DIGITALI"), ncols)
    dig_abbinate_cols = with_tier_pair(find_col(headers, ncols, "COPIE DIGITALI ABBINATE"), ncols)
    dig_promo_cols = find_col(headers, ncols, "COPIE DIGITALI PROMOZIONALI")
    pagata_italia_cols = find_col(headers, ncols, "DIFFUSIONE PAGATA", "ITALIA")
    totale_cart_dig_cols = find_col(headers, ncols, "CARTACEA", "DIGITALE", exclude=("TIRATURA",))
    # single-column leaf labels: raw (unfilled) match is unambiguous
    vendite_ind_cart_cols = find_col(headers, ncols, "VENDITE INDIVIDUALI CARTACEE")
    abb_ind_cart_cols = find_col(headers, ncols, "ABBONAMENTI INDIVIDUALI CARTACEI")
    vendite_mult_cart_cols = find_col(headers, ncols, "VENDITE MULTIPLE", "CARTACEE PAGATE")
    abb_mult_cart_cols = find_col(headers, ncols, "ABBONAMENTI MULTIPLI CARTACEI")

    tiratura_col = tiratura_cols[0] if tiratura_cols else None
    pagata_col = pagata_italia_cols[0] if pagata_italia_cols else None
    grand_total_col = totale_cart_dig_cols[0] if totale_cart_dig_cols else None
    # digital SOLD (subscriptions/purchases) only - excludes bundled copies
    # given free with a print sub and promotional/omaggio copies, so that
    # print_paid + digital_sold reconciles exactly to the official
    # "Totale diffusione pagata Italia" column (verified below).
    digital_cols = dig_ind_cols + dig_mult_cols
    print_paid_cols = vendite_ind_cart_cols + abb_ind_cart_cols + vendite_mult_cart_cols + abb_mult_cart_cols

    out = []
    for row in rows:
        name = row[name_col] if name_col < len(row) else None
        if not name:
            continue
        name_up = norm(name)
        if name_up not in TARGETS:
            continue
        # sanity check this is a data row: anno-ish numeric should appear somewhere in cols 4-7
        def g(col):
            if col is None or col >= len(row):
                return None
            v = row[col]
            return v if isinstance(v, (int, float)) else None

        tiratura = g(tiratura_col)
        pagata = g(pagata_col)
        grand_total = g(grand_total_col)
        digital_total = sum(g(c) or 0 for c in digital_cols) if digital_cols else None
        print_paid_total = sum(g(c) or 0 for c in print_paid_cols) if print_paid_cols else None
        if tiratura is None:
            continue  # header/blank row picked up by mistake
        check = None
        if print_paid_total is not None and digital_total is not None and pagata is not None:
            check = (print_paid_total + digital_total) - pagata
        out.append({
            "testata": TARGETS[name_up],
            "source": source,
            "tipo": tipo,
            "anno": anno_label,
            "tiratura": tiratura,
            "print_pagato": print_paid_total,
            "digitale_venduto": digital_total,
            "diffusione_pagata_italia": pagata,
            "totale_cartacea_digitale": grand_total,
            "_check_print_plus_digital_minus_pagata": check,
        })
    return out


ALL_ROWS = []

# Monthly September snapshots 2015-2025 (periodicita 1 = quotidiani, 6 = settimanali)
for anno in range(2015, 2026):
    for per in (1, 6):
        fname = f"dms_{anno}_09_per{per}.xlsx"
        try:
            wb = openpyxl.load_workbook(fname, data_only=True)
        except FileNotFoundError:
            continue
        ws = wb.active
        ALL_ROWS.extend(parse_sheet(ws, anno, "DMS-settembre", fname))

# Annual certified/declared files
ANNUAL_FILES = [
    ("ReportMediaPeriodo_2021.xlsx", 2021, "CERT-annuale"),
    ("DatiCertificati2022.xlsx", 2022, "CERT-annuale"),
    ("DatiCertificati2023.xlsx", 2023, "CERT-annuale"),
    ("Certificati_2024.xlsx", 2024, "CERT-annuale"),
]
for fname, anno, tipo in ANNUAL_FILES:
    wb = openpyxl.load_workbook(fname, data_only=True)
    for sheet in wb.sheetnames:
        ALL_ROWS.extend(parse_sheet(wb[sheet], anno, tipo, fname))

FIELDS = ["testata", "source", "tipo", "anno", "tiratura", "print_pagato", "digitale_venduto", "diffusione_pagata_italia", "totale_cartacea_digitale"]
with open("ads_clean.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=FIELDS)
    writer.writeheader()
    for r in ALL_ROWS:
        writer.writerow({k: r[k] for k in FIELDS})

print(f"Wrote {len(ALL_ROWS)} rows to ads_clean.csv\n")
bad = [r for r in ALL_ROWS if r["_check_print_plus_digital_minus_pagata"] not in (0, None)]
print(f"Reconciliation mismatches (print_pagato+digitale_venduto != diffusione_pagata_italia): {len(bad)}")
for r in bad:
    print(" MISMATCH", r["testata"], r["anno"], r["source"], "delta=", r["_check_print_plus_digital_minus_pagata"])
for r in ALL_ROWS:
    print(r)
Codice: regressione lineare (equivalente Python di lm() in R)
import numpy as np
# x = anni (2015..2025), y = tiratura (o totale cartacea+digitale) di ogni anno
slope, intercept = np.polyfit(x, y, 1)
anno_zero_copie = -intercept / slope Ami Carter-Wilson